能力域:
研发团队新员工 DeepSeek Harness 使用规范 一、背景与问题 近期发现,部分新入职研发人员在几乎未阅读中型复杂项目完整代码的情况下,直接使用 DeepSeek Harness 进行祈祷式编程,并在聊天过程中完成代码生成与修改。由此产生以下问题: 二、规范目的 开发人员应重新理解需求、思考实现方式,避免祈祷式编程——即不经过需求分析与实现设计,直接将需求抛给工具、寄希望于其自动产出可用代码的做法。通过本规范,引导新入职研发人员建立正确的需求理解与实现设计习惯,保障项目代码质量与仓库安全。 三、规范要求 …

一、安装wsl 在microsoft store搜索安装ubuntu启用wsl,或者用超级管理员权限下执行安装wsl: 二、进入wsl 找到新增的ubuntu图标,点击后进入终端版ubuntu。自己初始化用户名和密码。 三、更新源安装python 创建虚拟环境 四、安装dsh 五、挂载dsh的工作目录 1、注意修改用户名,把thsmart替换成你的用户名 2、win11本地磁盘【我的文档】下的新建dsh文件夹,在dsh目录下面放代码文件夹,任务文件夹即可。 创建快捷打开dsh命令 编辑时 vim ~/dshw.sh…
文件分为图片和其他。文件可以通过公网可访问的url或者base64传递。文件不允许通过公网url访问,只允许先上传到文件系统,先获取fileid,然后把fileid传给/v1/chat/completions 接口即可。 图片公网URL案例: 图片Base64案例: 普通文件案例: 多图多文件混合的请求结构:
出处:https://www.bilibili.com/video/BV1jbXKBGECC/ spark_agent_learn.py 结构图 · 纯文字版 这是 spark_agent_learn_guide.md 里 9 张 Mermaid 图的纯文字对照版:不依赖任何渲染器,任何编辑器里都能读。约定:缩进表示"属于/由谁产生",-> 表示"然后/流向",[?] 表示判断分支。全文只用函数名、类名、常量名定位,不用行号。 图 1 · 全局架构(10 个部件与数据流) 图 2 · 主循环(含 5 个 Ho…
在现代数据平台中,数据处理链路通常可以抽象成: 如果数据采集使用 SeaTunnel,调度使用 DolphinScheduler,数据仓库使用 ClickHouse、Doris、Snowflake、BigQuery 等,那么还有一个非常关键的问题: 谁负责把这些原始数据转换成真正可以被业务使用的数据模型? 过去几年,这个问题几乎可以直接回答: dbt。 但现在,一个非常值得关注的竞争者出现了: SQLMesh。 两者表面上都可以写 SQL、建立模型、管理 DAG、执行测试,因此很多人会把 SQLMesh 简单理解为…
dbt中文教程文档见下: 文档目录 01 dbt 工程配置说明 工程:dbt_factory/(通用制造工厂数据中台)。数仓库 data/dwh.duckdb,源库 data/raw.duckdb(只读挂载)。实测:dbt build 全量 402/402 全部通过(详见 docs/run_report.md)。 1. 环境准备 1.1 软件版本(实测) 组件 版本 说明 Python 3.14.4 虚拟环境位于仓库根目录 venv/ dbt-core 1.12.3 数据转换框架 dbt-duckdb 1.11.0…
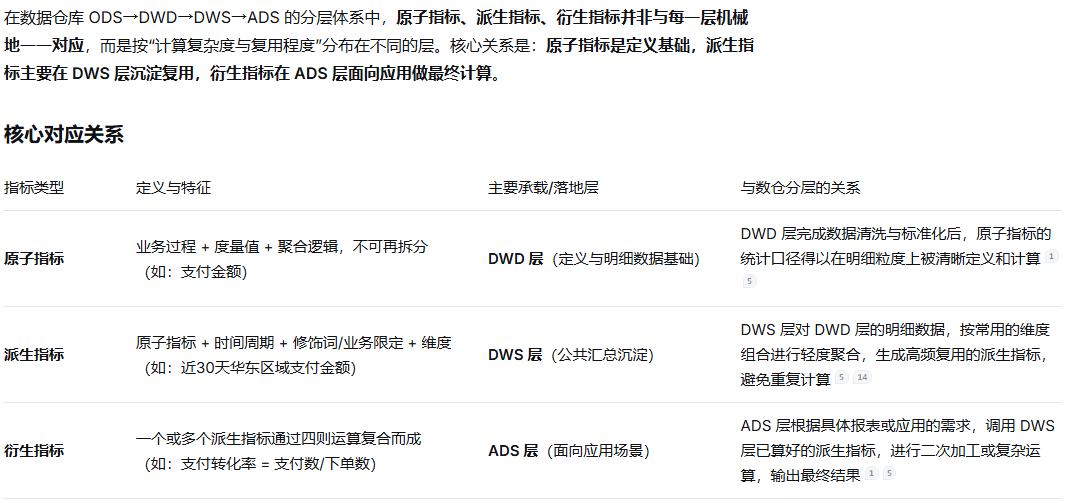
数字工厂决策系统,分析之前,根据业务流程,需要分析的维度,每种维度(组织维度:部门角色 要素维度:人机料法环 )观测尺度:年月日周下去定义指标。形成指标体系 数据需要先治理开发,开发中记录target-source的关系,形成血缘。 数据治理流程: ODS贴源层:原始数据表DWD明细层:数据清洗、去重纠错,改善数据质量。数据字典标准:人、机、料等建立统一字典,并对相关数据重映射。包含原子指标。DWS汇总层:按天/组织/人机料法环进行group聚合ADS应用层:计算派生指标,直接面向决策分析BI